Clustering
Sin pre-etiquetar dietas: el algoritmo descubre las 3 tipologías latentes a partir de la huella porcentual de 7 macrocategorías.
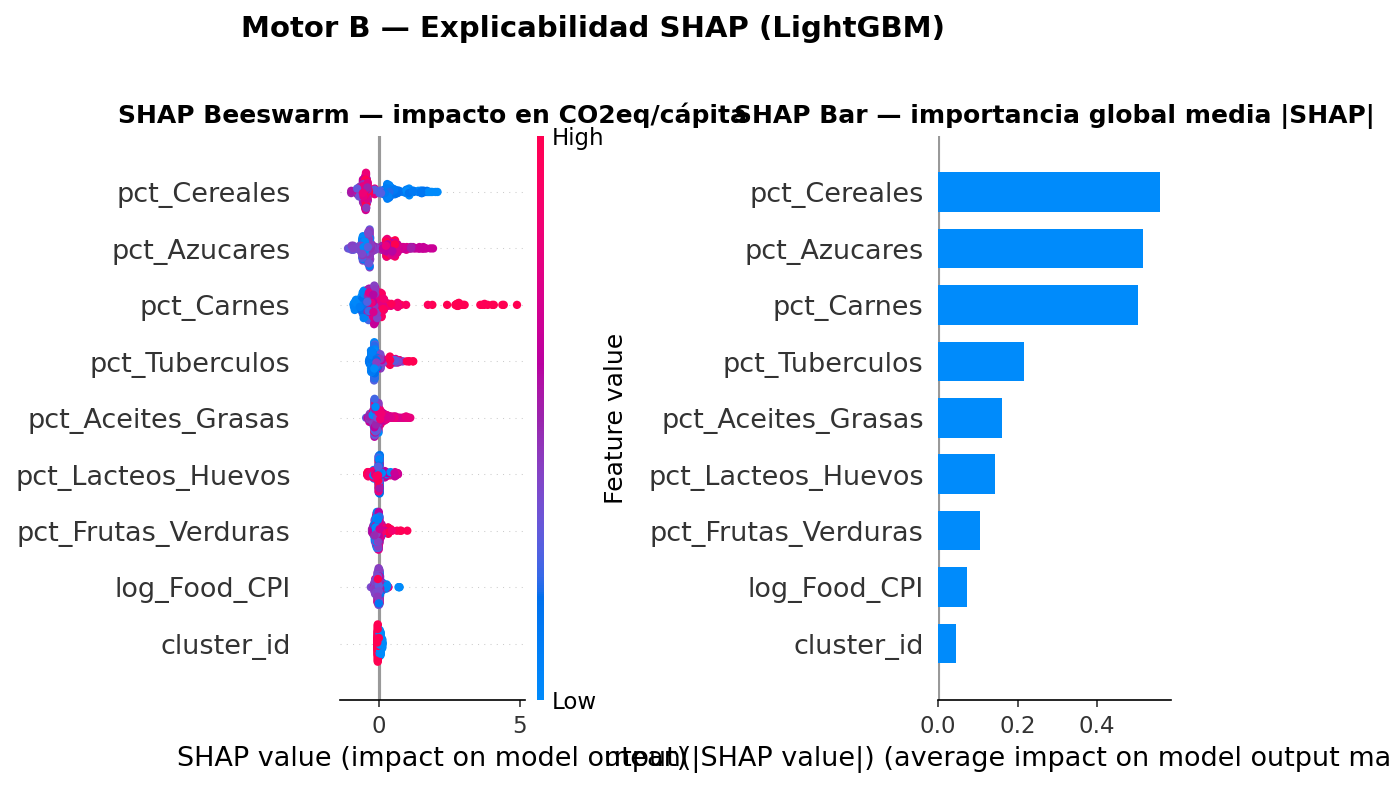
Agrupamos las dietas de 30 países sin etiquetarlas y entrenamos un modelo para predecir su huella de carbono. Los tres factores que encontró por su cuenta —cereales, azúcares y carnes— salen en el mismo orden que publica la literatura climática. Nunca se la enseñamos.
Cada motor ataca una dimensión distinta —qué se come, cuánto cuesta, cuánto emite— y sus salidas se triangulan en un único dashboard.
Sin pre-etiquetar dietas: el algoritmo descubre las 3 tipologías latentes a partir de la huella porcentual de 7 macrocategorías.
+57 puntos de R² sobre el baseline. SHAP identifica 9 drivers interpretables y reproduce la jerarquía IPCC sin conocimiento previo. Es el motor que corre más abajo, en esta misma página.
Forecast recursivo con intervalos de confianza por quantile regression. Supera a Prophet y SARIMAX en todas las métricas medidas.
Los 3 drivers principales del CO₂ que descubre SHAP —cereales, azúcares y carnes— coinciden con el orden de impacto climático que reportan Poore & Nemecek (2018, Science) para sistemas agroalimentarios.
Sin anclar el modelo a conocimiento previo, LightGBM aprende que la composición
dietaria contiene por sí sola la señal completa: el cluster_id aporta
solo 0,04 |SHAP| cuando ya están las 7 macrocategorías en el vector de entrada.
Esto valida el pipeline como método replicable: si dieras a otro equipo el mismo dataset sin contarle nada de emisiones, llegaría a las mismas conclusiones.
Validadas por Silhouette = 0,40 y una estabilidad temporal del 98,7 % en 13 años.
España, Francia, Alemania, Italia, Polonia, Reino Unido, Rumanía, Estados Unidos, Canadá, Argentina, Brasil, México, Colombia, Australia, Arabia Saudí, Kazajistán, Marruecos y Egipto.
Nigeria — el único país del dataset con una dieta dominada por yuca, ñame y batata. No es ruido: su huella es distintiva y estable en toda la ventana 2010–2022.
China, India, Indonesia, Vietnam, Tailandia, Bangladés, Pakistán, Corea del Sur, Etiopía, Kenia y Senegal.
Los controles alimentan el Motor B y devuelven su predicción de huella. No es una maqueta ni una fórmula aproximada: son los 500 árboles del modelo entrenado, el mismo fichero que carga el dashboard, ejecutándose en tu navegador.
Cómo leerlo: los porcentajes se normalizan a 100 % antes de entrar al modelo,
igual que en el dashboard. Las palancas se calculan moviendo cada macrocategoría
±2 puntos y volviendo a preguntar al modelo: es sensibilidad local real, medida en
el momento, no el ranking SHAP global.
Y un aviso honesto: un modelo de árboles no responde con una curva suave,
sino con escalones — al cruzar el umbral de una rama, la predicción salta de golpe.
Partiendo de España, subir las carnes de 14 % a 15,5 % dispara la huella de 2,4 a
6,3 t. Ese acantilado es real y está en una zona con pocos datos (390 observaciones
en total), así que se señala en vez de disimularlo: las palancas marcadas
escalón son saltos, no pendientes.
Cada nodo es una pieza del pipeline y las líneas son el flujo de datos. El eje horizontal es el avance temporal; el vertical, la naturaleza técnica. Pasa el ratón —o toca, en móvil— para ver el detalle de cada pieza.
El simulador de arriba es una pieza del Motor B. El dashboard trae las cinco vistas, con los datos en vivo desde los parquets procesados.